关于项目
三年前我接触了卷积神经网络CNN,并学习了一些Tensorflow,我相信这项技术能够让我做出一些强大的CV项目,在今年九月份我在AI的帮助下,终于做到了,隆重介绍CNN-CAPTCHA。
项目地址:https://github.com/fancc666/cnn-captcha
这里偷点懒直接把readme粘贴过来。
CNN captcha
介绍
基于 PyTorch 的固定 6 位验证码识别模型:从零训练、验证,并导出 ONNX 通用模型。
本案例是学习CNN架构的Demo,对于同类的,白底黑字,同一字体,随机干扰线,六位验证码类型,当前模型结构可以做到整串验证码接近85%的准确率,字符高于96%准确率,远高于OCR识别。
- 任务:识别
120 × 40RGB 验证码图片中的 6 位字符(字符集0-9a-z,共 36 类) - 输入:
[B, 3, 40, 120]原始 RGB 张量,不做任何预处理(干扰线由模型学习) - 输出:
[B, 6, 36],每一位字符在 36 个类别上的分数 - 参数量:423,864
训练数据未加入 Git 追踪,请前往 https://cdn.happyfan.cc.cd/public/captcha-data.zip 下载数据集,解压到
captcha/。
运行示例
图片见Github。
项目结构
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
mycaptcha/
├── captcha/                  # 数据集目录(8000 张 PNG,未纳入 Git)
│   ├── y196na.png            #   文件名即标签,如 y196na -> "y196na"
│   └── ...
├── captcha-data.zip          # 数据集压缩包(未纳入 Git)
├── model/                    # 权重与历史模型
│   ├── cpmv5-best.pth        #   当前最优权重,配套 model.py(v5 结构)
│   ├── cpmv1-e20.pth         #   旧版权重,配套 model/model-v1,2.py
│   ├── cpmv2-e25.pth         #   旧版权重,配套 model/model-v1,2.py
│   └── model-v1,2.py         #   旧版模型结构备份(v1/v2,整串准确率约 65%)
├── onnxrun/                  # ONNX 导出
│   ├── export_onnx.py        #   导出脚本
│   └── model-v5.onnx         #   已导出的 ONNX 模型(opset 18)
├── test/                     # 单图测试样本
│   ├── test.png
│   ├── test1.png
│   └── filtered.png
├── images/                   # 预留目录(README 配图等)
├── dataset.py                # 数据集加载 CaptchaDataset
├── model.py                  # 当前模型定义 CaptchaModel(v5)
├── train.py                  # 训练 + 验证 + 保存最优权重
├── check_one.py              # 单张图片快速推理
├── remove_lines.py           # 干扰线预处理(当前模型已不需要,仅作参考)
├── pyproject.toml            # 依赖与镜像源配置
└── uv.lock
各文件职责
| 文件 | 说明 |
|---|---|
dataset.py | CaptchaDataset:扫描 captcha/*.png,文件名转标签,ToTensor() 后返回 (image, label) |
model.py | CaptchaModel:当前使用的 v5 网络结构 |
train.py | 训练入口:8:2 划分训练/验证集,交叉熵 + Adam + 余弦退火,按整串准确率保存最优权重 |
check_one.py | 加载 cpmv5-best.pth 对 test/test1.png 做单图推理并打印结果 |
onnxrun/export_onnx.py | 将 PyTorch 权重导出为 ONNX,便于跨语言部署 |
model/model-v1,2.py | 旧版结构备份,仅用于加载 cpmv1/cpmv2 权重做对比 |
模型结构
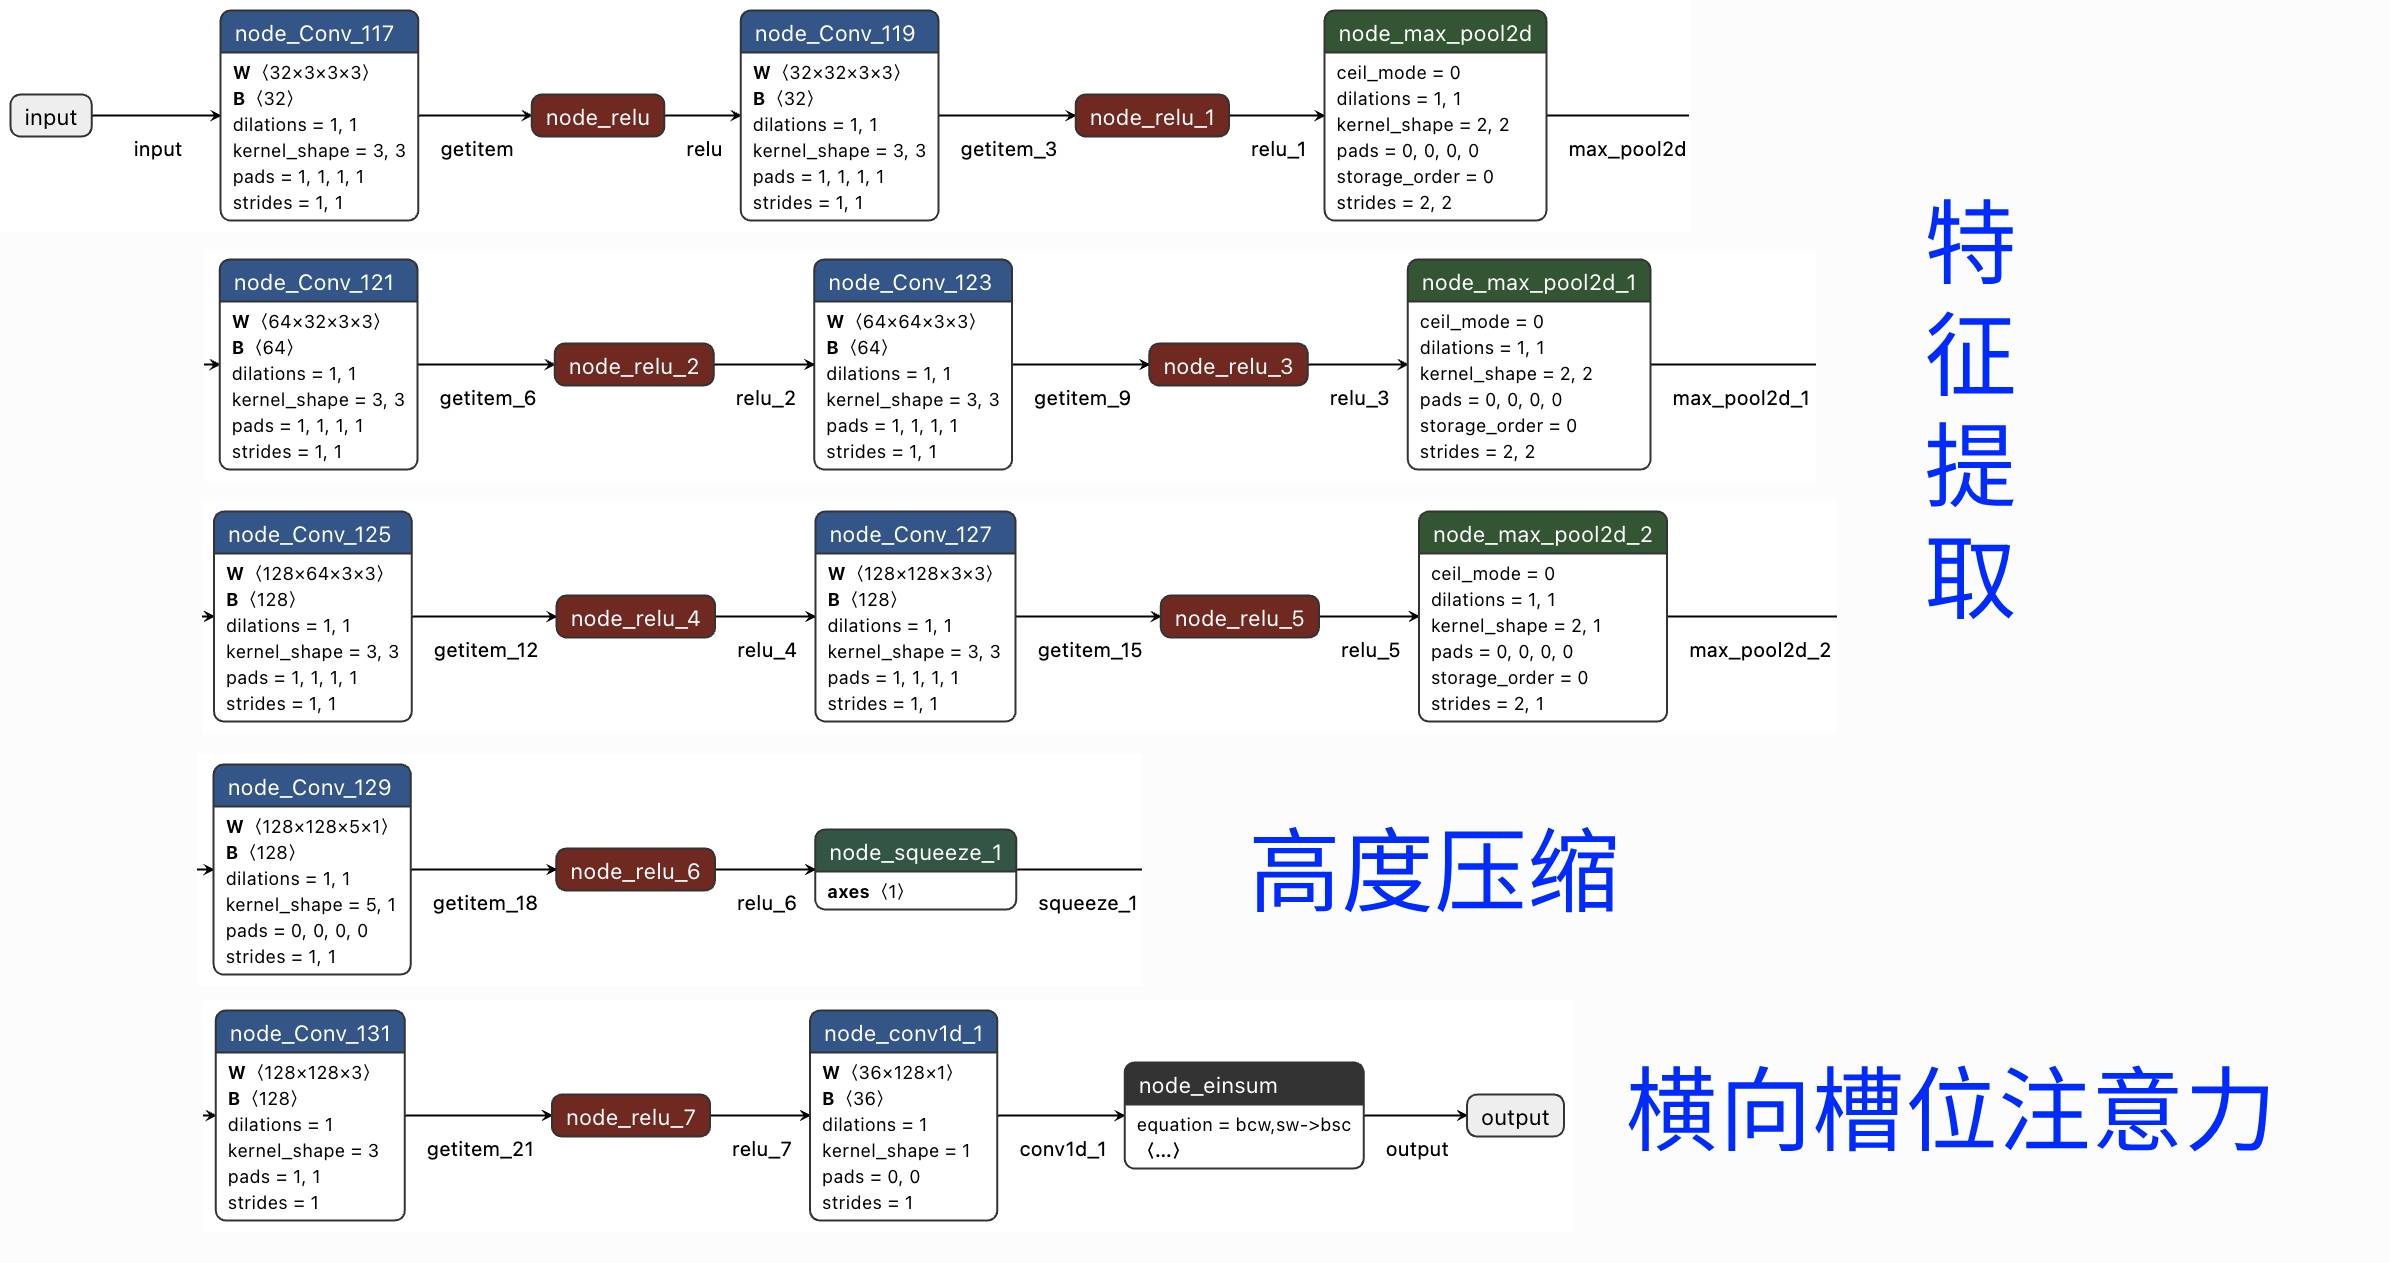
model.py 中的 CaptchaModel 采用「CNN 特征提取 + 竖直加权池化 + 逐列打分 + 槽位注意力池化」的设计。
关键设计动机
- 宽度方向只池化 2 次:
120px → 30 格,每格 4px。字符步进约 15px,若池化 3 次会得到 8px/格,比字符本身还粗,定位精度不够。 - 头部不用固定步长卷积切 6 个槽位,而是「逐列打分 + 每槽注意力池化」。字体是比例字体、字符落点会漂移,在 30 格上凑出恰好 6 个输出的固定网格必然错位;注意力池化让每个槽自己决定看哪几列。
数据流
| 阶段 | 模块 | 输出形状 |
|---|---|---|
| 输入 | — | [B, 3, 40, 120] |
| 特征提取 block 1 | Conv-BN-ReLU ×2 + MaxPool(2) | [B, 32, 20, 60] |
| 特征提取 block 2 | Conv-BN-ReLU ×2 + MaxPool(2) | [B, 64, 10, 30] |
| 特征提取 block 3 | Conv-BN-ReLU ×2 + MaxPool((2,1)) | [B, 128, 5, 30] |
| 竖直加权池化 | Conv2d(kernel=(5,1)) + BN + ReLU | [B, 128, 1, 30] |
| 逐列打分 | Conv1d(k=3,pad=1) + BN + ReLU + Conv1d(k=1) | [B, 36, 30] |
| 槽位注意力池化 | softmax(slot_attn) + einsum("bcw,sw->bsc") | [B, 6, 36] |
三个核心模块
1. 特征提取 features
每个 block 为 Conv3×3 → BN → ReLU → Conv3×3 → BN → ReLU → MaxPool,共 3 个 block,通道 3 → 32 → 64 → 128。第三个 block 的池化核为 (2, 1),即高度继续压缩、宽度保持不变,从而保留 30 个宽度格。
2. 竖直加权池化 height_pool
用 kernel_size=(5, 1) 的卷积把高度 5 → 1,得到每个通道在竖直方向的可学习加权(而非 AvgPool2d 的固定平均)。验证码文字基线固定在 y=30,竖直位置是确定的,因此这一步可以放心压掉高度。
3. 槽位注意力池化 slot_attn
- 形状
[6, 30]的可学习参数,对宽度维做softmax得到每个槽在 30 格上的注意力分布。 - 用高斯位置先验初始化:文字占
px 10~97,6 等分得到 6 个字符中心,按-(col - center)² / (2σ²)生成初值(attn_sigma默认2.5,控制学习窗口宽度)。 - 若全零初始化,
softmax后 6 个槽完全相同、输出也完全相同,梯度无法打破对称性,因此必须先验初始化。 - 前向用
torch.einsum("bcw,sw->bsc", x, attn)把逐列分数聚合成 6 个槽位分数。
快速使用
1. 环境准备
需要 Python >= 3.12。项目使用uv管理依赖:
1
uv sync
或使用 pip:
1
pip install "torch>=2.14.0" "torchvision>=0.29.0" "pillow>=12.3.0"
导出 ONNX 还需
onnxscript;用 ONNX 推理需自行安装onnxruntime(当前pyproject.toml未包含)。
2. 准备数据集
下载并解压到项目根目录下的 captcha/:
1
2
3
curl -L -o captcha-data.zip https://cdn.happyfan.cc.cd/public/captcha-data.zip
unzip captcha-data.zip          # 压缩包内为 data/ 目录
mv data captcha                 # 确保最终路径为 ./captcha/*.png
要求:PNG 格式、120 × 40 RGB,文件名(不含扩展名)就是 6 位标签,例如 y196na.png 对应标签 y196na。
3. 训练
1
python train.py
默认超参(见 train.py 顶部):
| 参数 | 默认值 | 说明 |
|---|---|---|
EPOCHS | 40 | 迭代轮次 |
BATCH_SIZE | 64 | 批大小 |
LR | 1e-3 | 初始学习率,余弦退火至 0 |
EVAL_EVERY | 5 | 每 5 轮评估一次验证集 |
CKPT | cpmv5-best.pth | 按验证集整串准确率保存最优权重 |
训练细节:
- 数据集按 8 : 2 随机划分训练/验证集(
manual_seed(42),划分可复现)。 - 损失为 6 个位置交叉熵的平均:
loss = Σ CE(outputs[:, i, :], labels[:, i]) / 6。 - 优化器
Adam,学习率调度CosineAnnealingLR(T_max=EPOCHS)。 - 设备自动选择:
mps(Apple Silicon)→ 否则cpu。NVIDIA 显卡请手动改为cuda。 - 每轮打印 loss 与当前学习率;评估时打印字符准确率、整串准确率、逐位准确率。
- 训练结束会打印 6 个槽位的注意力分布条形图:若 6 个峰值分得很开且落在文字区域内,说明对齐学到了;若挤成一团,需调整
CaptchaModel(attn_sigma=...)。
4. 单图推理
把待测图片放到 test/,修改 check_one.py 中的文件名(默认 test/test1.png)后运行:
1
python check_one.py
脚本会加载 model/cpmv5-best.pth,输出预测的 6 位字符串。
5. 导出 ONNX
1
python onnxrun/export_onnx.py
生成 onnxrun/model-v5.onnx(opset 18,输入名 input,输出名 output,固定输入 1×3×40×120)。
ONNX 推理示例:
1
2
3
4
5
6
7
8
9
10
11
12
import numpy as np
import onnxruntime as ort
from PIL import Image

chars = "0123456789abcdefghijklmnopqrstuvwxyz"

sess = ort.InferenceSession("onnxrun/model-v5.onnx")
img = Image.open("test/test1.png").convert("RGB")
x = np.asarray(img, dtype=np.float32).transpose(2, 0, 1)[None] / 255.0  # [1,3,40,120]

logits = sess.run(["output"], {"input": x})[0]        # [1, 6, 36]
print("".join(chars[i] for i in logits[0].argmax(axis=1)))
6. 在自己的代码里调用
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
import torch
from torchvision import transforms
from PIL import Image
from model import CaptchaModel

chars = "0123456789abcdefghijklmnopqrstuvwxyz"
device = torch.device("mps" if torch.mps.is_available() else "cpu")

model = CaptchaModel().to(device)
model.load_state_dict(torch.load("model/cpmv5-best.pth", map_location=device))
model.eval()

img = transforms.ToTensor()(Image.open("test/test1.png").convert("RGB"))
with torch.no_grad():
    logits = model(img.unsqueeze(0).to(device))       # [1, 6, 36]
    pred = logits.argmax(dim=2)[0]
print("".join(chars[i] for i in pred))
常见问题
图片尺寸或格式不对? 模型输入固定为 120 × 40 RGB,且不做任何 resize 或归一化以外的预处理。请确保待测图片与训练集同源同尺寸,否则准确率会大幅下降。
权重加载报错 Missing key(s) / Unexpected key(s)? 权重与模型结构必须严格对应。cpmv5-best.pth 只能配 model.py 的 CaptchaModel;cpmv1-e20.pth、cpmv2-e25.pth 需要 model/model-v1,2.py 中的旧结构。
训练很慢? 确认设备输出为 mps 或 cuda。若回退到 cpu,请检查 PyTorch 版本与显卡驱动。
开源
本项目使用MIT协议开源。